¿Creando agentes? Dejen de tratar los mensajes como una base de datos.
Deja de usar mensajes como memoria de tu agente. Descubre cómo el estado estructurado hace que los agentes de IA sean más confiables, eficientes y listos para producción.
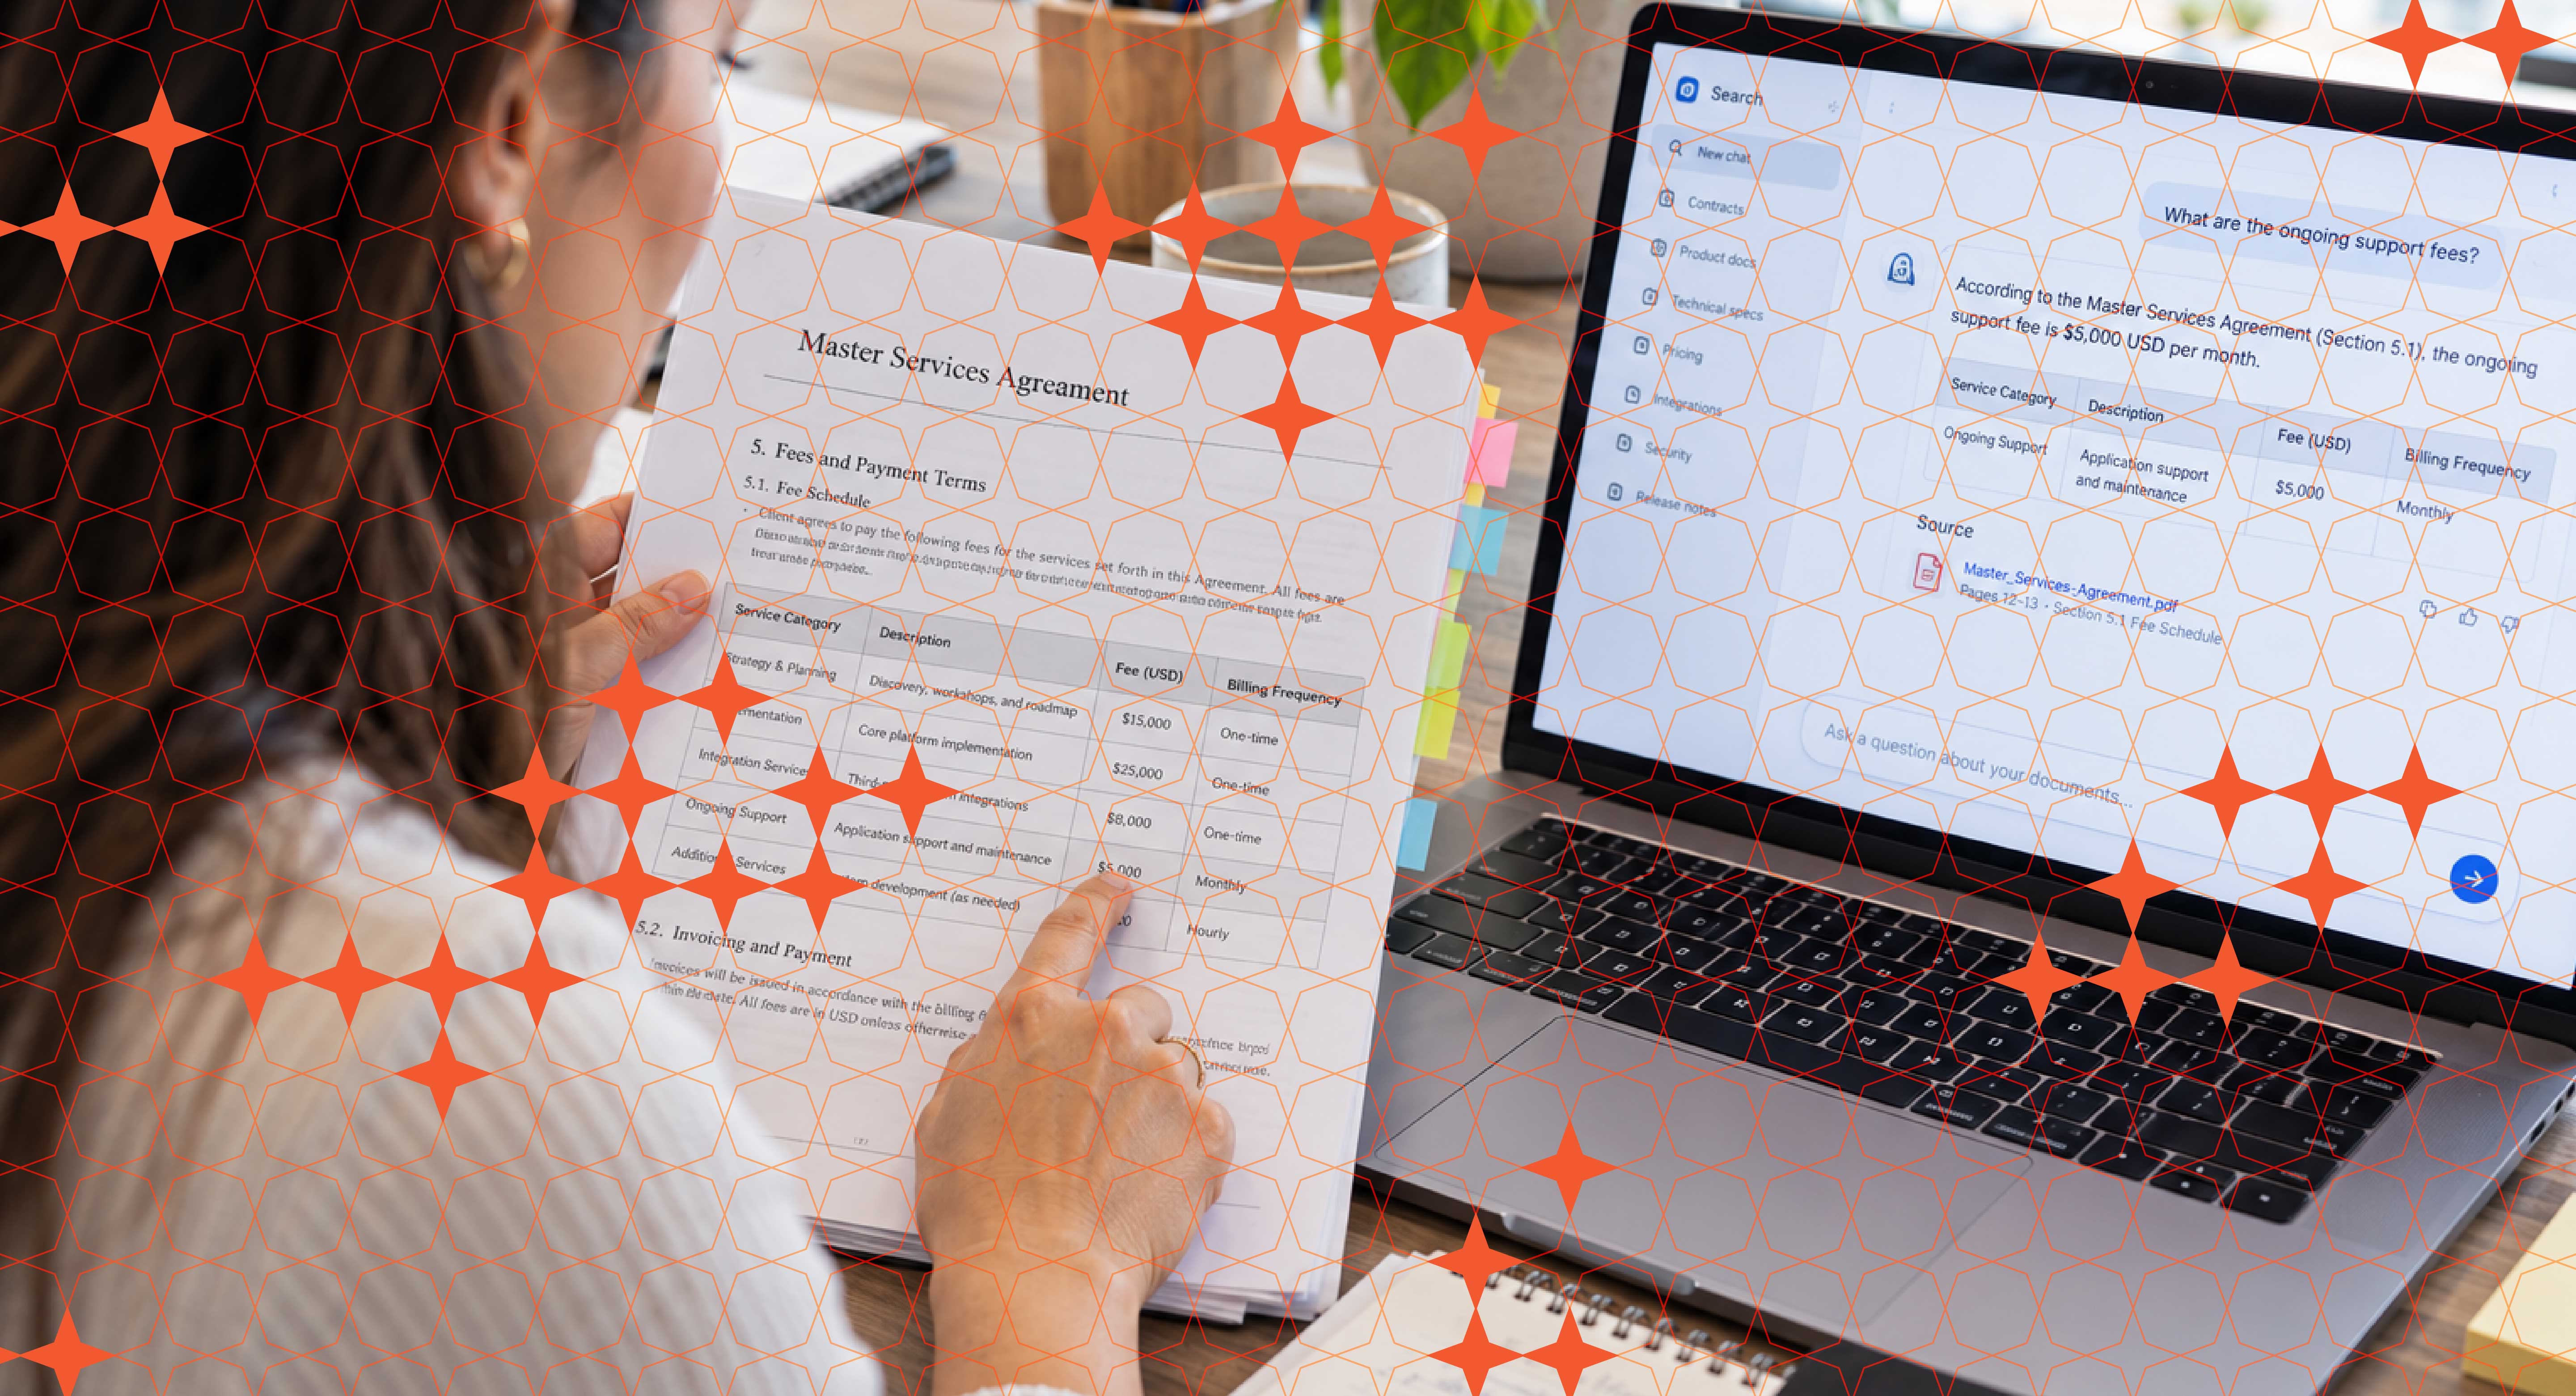
Si eres propietario de un producto digital, la búsqueda con IA llega a tu hoja de ruta con una pregunta práctica: ¿Dónde debería invertirse el próximo dólar?
En Pureinsights, ayudo a las empresas a llevar la búsqueda con IA del piloto a la producción, y la respuesta comienza por entender cómo se construyen estos sistemas. La búsqueda con IA funciona en cuatro capas:
Cada una de las tres primeras establece un límite para la siguiente. El contenido determina lo que la búsqueda puede encontrar, y la búsqueda determina lo que la respuesta puede decir. Lograr que una capa funcione bien mientras se descuidan las demás produce un sistema que quizás nunca llegue a producción, por lo que el orden en que se invierte importa.
Lo que sigue es la decisión clave que tomamos en cada capa, extraída de nuestro ebook, Making AI Search Work, que profundiza en cada una de ellas.
La mayoría de las implementaciones comienzan dividiendo cada documento en fragmentos de igual tamaño, ignorando los encabezados y el diseño. El resultado es que el significado se pierde en los cortes: una fila de tabla queda en un fragmento y su título en otro, o una cláusula que dice "véase el Artículo 7" se almacena sin ningún rastro de lo que dice dicho artículo. Dividir el contenido siguiendo su propia estructura mantiene esos fragmentos completos. (Esto significa que también es necesario conservar las tablas. A menudo contienen las respuestas más precisas, como tarifas y valores de especificaciones, y es posible que los clientes en una interfaz de chat nunca abran el documento original para encontrarlas.)
La búsqueda semántica, que relaciona el significado en lugar de palabras exactas, responde bien a la mayoría de las preguntas. Los fallos se producen en el resto: solicitudes de la redacción exacta de una cláusula de política, búsquedas por número de pieza o SKU, y preguntas sobre la versión actual de un documento cuando los borradores anteriores siguen indexados. En cada caso, la búsqueda semántica devuelve algo aproximado en lugar de algo exacto, y una o dos respuestas incorrectas pero presentadas con seguridad son suficientes para socavar la confianza de los usuarios.
La forma principal de abordar esto es clasificar primero cada pregunta y luego enviarla a un especialista. Las citas se derivan a la búsqueda de texto exacto, y todo lo que sea sensible al tiempo se envía a una búsqueda que sabe qué versión es la actual. En todos nuestros despliegues, ningún otro cambio ha mejorado tanto la precisión. La clasificación tarda milisegundos y reduce costes, ya que los métodos más costosos solo se ejecutan cuando una pregunta los requiere.
La clasificación por relevancia es la otra mitad de la solución. El contenido desactualizado o no oficial es sistemáticamente el principal problema de confianza que observamos. Ponderar los resultados por tipo de fuente y fechas de vigencia mantiene los documentos actuales y oficiales en los primeros puestos, y devolver el fragmento exacto de la fuente junto con cada respuesta permite a los usuarios verificarlo por sí mismos.
De forma predeterminada, las respuestas generadas no son lo suficientemente conservadoras cuando hay responsabilidad legal de por medio. La mayor parte de la solución está en las instrucciones: responder únicamente a partir de los fragmentos recuperados, citarlos y ser explícito al indicar cuándo estos no cubren la pregunta.
Las preguntas de múltiples partes requieren un tratamiento propio. "¿Puedo devolver un artículo en oferta que compré en línea en una tienda de otro país?" agrupa varias políticas en una sola oración, y una búsqueda única devuelve una respuesta que cubre solo una parte, sin indicarle al cliente qué información falta. Este tipo de preguntas suele representar la mayor brecha entre la precisión en pruebas y la precisión en el mundo real. Dividirlas en partes antes de realizar la búsqueda es lo que permite cerrar esa brecha.
A escala, el tiempo de respuesta se convierte en la restricción, y el lugar donde se ejecuta cada paso importa. Cada consulta que llama a un servicio de IA externo añade un viaje de ida y vuelta, y el tiempo de respuesta de ese servicio está fuera de tu control.
Un proyecto puede ilustrar la magnitud del efecto: un cliente tenía como objetivo que el 95 por ciento de las respuestas llegaran en menos de 400 milisegundos a 65 consultas por segundo, pero su tiempo de respuesta en el percentil 95 se situaba por encima de los 600 milisegundos. Para resolver ese problema, trasladamos el paso que convierte cada pregunta en un formato de búsqueda desde un servicio externo a un equivalente de código abierto ejecutándose en AWS SageMaker, junto a la plataforma de búsqueda. ¿El resultado? Con el mismo tráfico, el 95 por ciento de las respuestas llegaron en tan solo 144 milisegundos.
Una nota final: las optimizaciones de costos, como comprimir ese formato de búsqueda, sacrifican algo de precisión. Antes de que alguien optimice, construye un conjunto de consultas de referencia: una lista fija de preguntas reales con respuestas correctas conocidas, y prueba cada cambio contra ella.
Hacerlo bien no se trata de resolver todo hoy. Se trata de construir la base, paso a paso, para lograr los resultados que necesitas. Haz una pregunta por capa, en orden:
Si la respuesta a la primera pregunta es no, ahí es donde va la próxima inversión.
Esta publicación cubre una decisión por capa. El libro electrónico va más allá, con los seis cambios que tuvieron el mayor impacto en nuestras implementaciones, cómo convertir solicitudes como "presentaciones de ventas del año pasado" en filtros de búsqueda precisos, cuándo vale la pena agregar un grafo de conocimiento y cómo un cliente liberó un clúster de búsqueda completo al consolidar índices duplicados.
Matt Willsmore es Arquitecto Principal en Pureinsights, donde ayuda a las empresas a llevar la búsqueda con IA y RAG del piloto a la producción. Lee su análisis técnico completo sobre este tema o puedes descargar el libro electrónico completo, Making AI Search Work: Lessons from the Field on RAG in Production.
Deja de usar mensajes como memoria de tu agente. Descubre cómo el estado estructurado hace que los agentes de IA sean más confiables, eficientes y listos para producción.

Los enfoques tradicionales de gestión del cambio no funcionaban antes. La IA simplemente hace que sea imposible ignorar las brechas.

Cómo las empresas inteligentes están evolucionando con modelos de entrega impulsados por agentes y qué se necesita para liderar en la nueva era de los servicios inteligentes.